Đang tải mục lục...
Token là gì trong AI? Cách tính token và giới hạn ChatGPT
Tóm tắt nhanh
Thu gọn
Token là gì trong AI? Tìm hiểu cách chia văn bản thành token, quy đổi số từ, kiểm tra token ChatGPT và cách tối ưu chi phí qua ví dụ thực tế.
Token là đơn vị nhỏ mà các mô hình AI như ChatGPT, Gemini hoặc Claude sử dụng để xử lý ngôn ngữ. Số lượng token ảnh hưởng đến lượng thông tin AI có thể tiếp nhận, độ dài câu trả lời và chi phí khi sử dụng API. Vậy một token bằng bao nhiêu từ, cách tính như thế nào và làm sao để sử dụng hiệu quả? Hãy cùng Connect Tech tìm hiểu qua những ví dụ đơn giản dưới đây.
Token là gì trong AI?
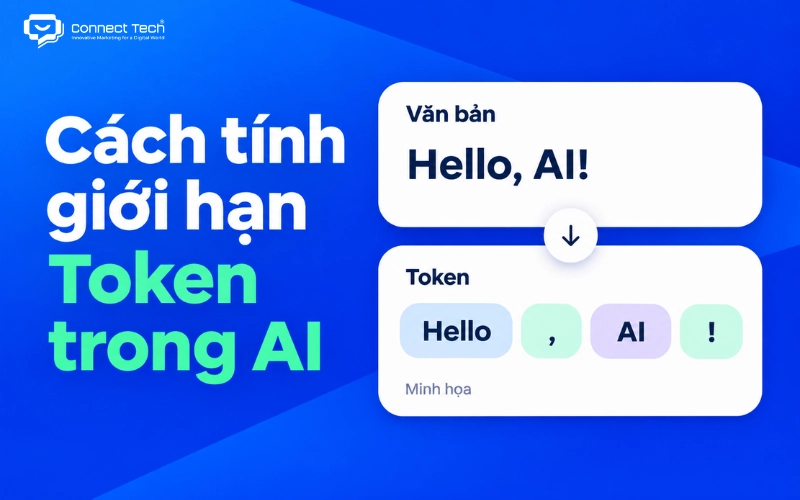
Token là đơn vị cơ bản giúp mô hình AI đọc, phân tích và tạo ra văn bản. Thay vì luôn xử lý từng từ hoàn chỉnh, các mô hình ngôn ngữ lớn (Large Language Model – LLM) chia nội dung thành những phần nhỏ hơn để máy tính có thể xử lý.
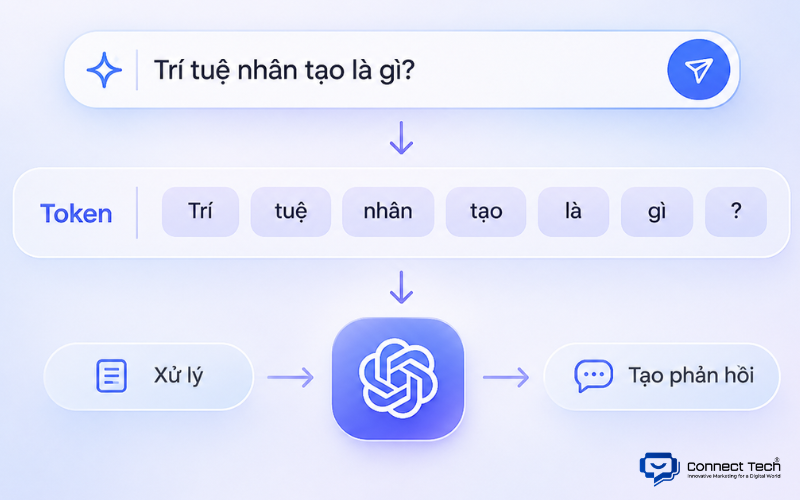
Chẳng hạn, khi bạn nhập câu hỏi "Trí tuệ nhân tạo là gì?" vào ChatGPT, hệ thống sẽ chuyển câu hỏi thành một chuỗi các đơn vị nhỏ trước khi xử lý. Những đơn vị này không nhất thiết trùng với từng từ mà bạn nhìn thấy.
Điều quan trọng là một token không luôn tương đương với một từ. Một từ ngắn có thể được biểu diễn bằng một đơn vị, trong khi từ dài hoặc ít phổ biến có thể được chia thành nhiều phần. Dấu câu và khoảng trắng cũng có thể ảnh hưởng đến cách chia.
Khi tìm hiểu token trong AI, bạn cũng cần phân biệt thuật ngữ này với những khái niệm cùng tên trong lĩnh vực khác. Ví dụ, blockchain sử dụng token để đại diện cho tài sản số, còn hệ thống bảo mật có thể dùng access token để cấp quyền truy cập. Chúng không có cùng chức năng với đơn vị xử lý ngôn ngữ của ChatGPT.
Token hoạt động như thế nào trong AI?
AI xử lý văn bản bằng cách chuyển nội dung đầu vào thành những đơn vị nhỏ, phân tích chúng và tạo ra các đơn vị mới để hình thành câu trả lời. Quá trình này diễn ra tự động nên người dùng thường chỉ nhìn thấy câu hỏi và kết quả cuối cùng.
Tokenization là gì và hoạt động như thế nào?
Tokenization là quá trình chia văn bản thành các đơn vị mà mô hình AI có thể xử lý. Thành phần đảm nhiệm công việc này được gọi là tokenizer.
Bạn có thể hình dung cách ChatGPT xử lý một câu hỏi qua bốn bước:
- Tiếp nhận văn bản: Người dùng nhập câu hỏi, yêu cầu hoặc cung cấp tài liệu.
- Chia nhỏ nội dung: Tokenizer phân tách văn bản thành các đơn vị theo bộ mã hóa của mô hình.
- Xử lý ngữ cảnh: Mỗi đơn vị được chuyển thành mã số (Token ID) và dạng biểu diễn số để mô hình phân tích mối liên hệ giữa các phần nội dung.
- Tạo câu trả lời: Mô hình dự đoán những đơn vị tiếp theo, sau đó chuyển kết quả thành văn bản dễ đọc.
Ví dụ, bạn yêu cầu:
Hãy giải thích trí tuệ nhân tạo cho học sinh lớp 6.
ChatGPT sẽ xử lý nội dung yêu cầu, xác định chủ đề cần giải thích và sử dụng ngữ cảnh để tạo câu trả lời phù hợp với học sinh lớp 6. Quá trình này không đơn giản là tìm từng từ có sẵn rồi ghép lại, mà dựa trên những mối quan hệ mô hình đã học trong quá trình huấn luyện.
Cách chia văn bản còn phụ thuộc vào bộ mã hóa (Encoding). Vì vậy, cùng một câu hỏi có thể tạo ra số lượng đơn vị khác nhau khi được xử lý bằng các mô hình khác nhau.
Input Token và Output Token khác nhau thế nào?
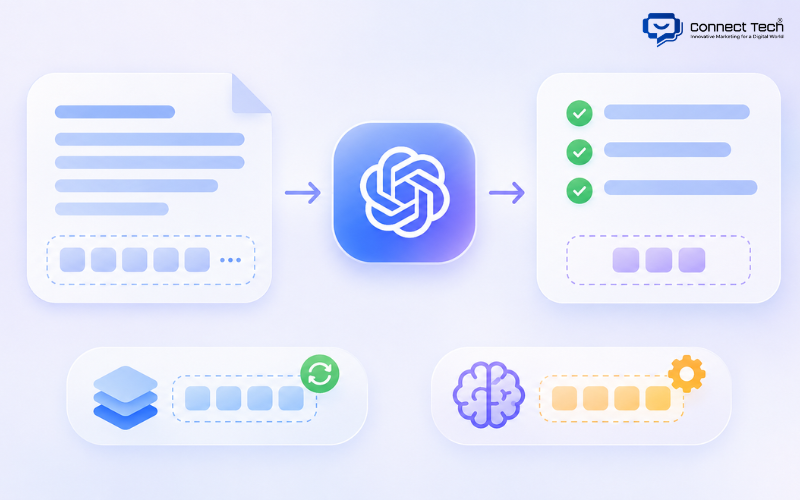
Input Token là đơn vị dữ liệu AI nhận vào, còn Output Token là đơn vị mà mô hình tạo ra trong phản hồi. Đây là hai khái niệm bạn sẽ thường gặp khi đọc tài liệu về ChatGPT hoặc sử dụng API.
Ví dụ, bạn cung cấp một đoạn văn dài và yêu cầu ChatGPT tóm tắt thành ba ý chính. Đoạn văn cùng yêu cầu tóm tắt thuộc phần đầu vào, còn ba ý chính mà AI tạo ra thuộc phần đầu ra.
Cached input giúp ứng dụng có thể tái sử dụng những phần ngữ cảnh lặp lại. Reasoning token lại phục vụ quá trình xử lý các yêu cầu cần nhiều bước suy luận, chẳng hạn giải toán hoặc phân tích vấn đề phức tạp.
Đáng chú ý, số lượng đơn vị đầu ra được ghi nhận không nhất thiết trùng với phần văn bản hiển thị. Một số mô hình còn tạo ra những thành phần nội bộ mà người dùng không trực tiếp nhìn thấy.
Một token bằng bao nhiêu từ và ký tự?
Một token tương đương khoảng 4 ký tự hoặc 0,75 từ tiếng Anh trong cách ước tính thông dụng của OpenAI. Tuy nhiên, đây chỉ là tỷ lệ tham khảo, không phải công thức áp dụng chính xác cho tất cả ngôn ngữ và mô hình.
Số lượng thực tế phụ thuộc vào cách viết, độ dài từ, dấu câu, khoảng trắng và bộ tokenizer được sử dụng.
1.000 token tương đương bao nhiêu từ tiếng Anh?
1.000 token tương đương khoảng 750 từ tiếng Anh theo quy tắc ước tính của OpenAI. Bạn có thể tham khảo bảng dưới đây để hình dung độ dài văn bản.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Nguồn: Tính theo tỷ lệ tham khảo 1 token ≈ 0,75 từ tiếng Anh của OpenAI.
Chẳng hạn, một bài viết tiếng Anh dài khoảng 1.500 từ có thể tương đương khoảng 2.000 đơn vị xử lý. Tuy nhiên, văn bản chứa nhiều thuật ngữ chuyên ngành, mã lập trình hoặc ký hiệu đặc biệt có thể cho kết quả khác đáng kể.
Vì vậy, bạn chỉ nên sử dụng bảng quy đổi để ước lượng độ dài. Nếu cần kiểm tra giới hạn của một mô hình hoặc tính chi phí API, hãy sử dụng công cụ đếm phù hợp.
Cách tính token tiếng Việt có gì khác tiếng Anh?
Văn bản tiếng Việt có thể được chia thành nhiều đơn vị xử lý hơn so với văn bản tiếng Anh có nội dung tương đương. Nguyên nhân đến từ đặc điểm ngôn ngữ và cách bộ mã hóa của từng mô hình được xây dựng.
Tiếng Việt sử dụng dấu thanh và khoảng trắng giữa các âm tiết. Trong khi đó, nhiều từ tiếng Anh được viết liền và có thể xuất hiện thường xuyên trong dữ liệu mà tokenizer sử dụng.
Hãy thử so sánh hai câu có ý nghĩa gần tương đương:
- Tiếng Việt: Hãy tóm tắt bài viết này thành ba ý chính.
- Tiếng Anh: Summarize this article in three key points.
Khi đưa hai câu vào cùng một tokenizer, bạn có thể nhận được số lượng đơn vị khác nhau. Mức chênh lệch cần được đo bằng công cụ cụ thể, không thể xác định chính xác chỉ bằng cách đếm số từ.
Ngoài ra, cùng một nội dung tiếng Việt cũng có thể cho kết quả khác nhau giữa các bộ mã hóa của OpenAI, Google và Anthropic.
Do đó, không có cơ sở để khẳng định tiếng Việt luôn tiêu tốn gấp đôi hoặc gấp ba lần so với tiếng Anh. Bạn nên kiểm tra trực tiếp nếu đang cần ước tính độ dài tài liệu hoặc chi phí xử lý.
Token ảnh hưởng như thế nào khi sử dụng ChatGPT?
Số lượng đơn vị xử lý ảnh hưởng đến lượng thông tin ChatGPT có thể sử dụng trong một yêu cầu và chi phí khi ứng dụng gọi API. Tuy nhiên, bạn cần phân biệt giới hạn ngữ cảnh, giới hạn đầu ra và hạn mức sử dụng dịch vụ vì chúng không giống nhau.
Trong một cuộc trò chuyện, không gian ngữ cảnh có thể chứa nhiều thành phần:
- Câu hỏi và hướng dẫn của người dùng.
- Nội dung từ những lượt trao đổi trước đó.
- Tài liệu, dữ liệu hoặc thông tin được bổ sung.
- Phần dành cho câu trả lời và quá trình suy luận của mô hình.
Giả sử bạn yêu cầu ChatGPT phân tích một tài liệu dài 100 trang. Nếu lượng dữ liệu cần xử lý vượt giới hạn được hỗ trợ, hệ thống có thể từ chối yêu cầu, rút gọn nội dung hoặc sử dụng cơ chế quản lý ngữ cảnh khác, tùy mô hình và ứng dụng.
Đây là lý do việc gửi quá nhiều thông tin vào cùng một cuộc trò chuyện đôi khi gây khó khăn khi cần phân tích tài liệu dài.
Tuy nhiên, context window lớn không đồng nghĩa với khả năng ghi nhớ hoàn hảo. Ngay cả khi toàn bộ nội dung nằm trong giới hạn cho phép, AI vẫn có thể bỏ sót chi tiết hoặc hiểu sai thông tin.
Một điểm cần phân biệt nữa là maximum output tokens. Thông số này quy định giới hạn đầu ra của mô hình, trong khi context window liên quan đến lượng ngữ cảnh mà mô hình có thể làm việc. Cả hai giới hạn đều phụ thuộc vào mô hình được lựa chọn.
Chi phí sử dụng API AI thường phụ thuộc vào số lượng đơn vị đầu vào, đầu ra và bảng giá của mô hình. Các nhà cung cấp như OpenAI, Google và Anthropic có thể áp dụng đơn giá khác nhau cho từng loại.
Cách tính cơ bản đối với một API tính phí theo triệu đơn vị là:
Chi phí = (Số lượng đầu vào × Đơn giá đầu vào + Số lượng đầu ra × Đơn giá đầu ra) / 1.000.000
Ví dụ minh họa, một mô hình có mức giá giả định:
- Input: 1 USD / 1 triệu đơn vị.
- Output: 5 USD / 1 triệu đơn vị.
Nếu ứng dụng sử dụng 20.000 đơn vị đầu vào và tạo 4.000 đơn vị đầu ra, chi phí cơ bản sẽ là:
(20.000 × 1 + 4.000 × 5) / 1.000.000 = 0,04 USD.
Đây chỉ là ví dụ để giải thích phép tính, không phải báo giá của một mô hình cụ thể. Chi phí thực tế còn có thể phụ thuộc vào cached input, cơ chế ghi cache, xử lý hình ảnh, âm thanh hoặc các công cụ bổ sung.
Nhiều người tìm kiếm cụm “mua token ai” vì cho rằng phải mua từng đơn vị mới có thể sử dụng ChatGPT. Thực tế, ChatGPT và OpenAI API có cơ chế thanh toán riêng.
Khi dùng ChatGPT trên website hoặc ứng dụng, bạn sử dụng các tính năng và hạn mức theo gói dịch vụ. Còn khi lập trình viên tích hợp mô hình qua API, chi phí thường được tính dựa trên mức sử dụng thực tế.
Nếu cần dự toán ngân sách API, bạn nên tham khảo bảng giá chính thức của OpenAI và kiểm tra đơn giá của mô hình đang sử dụng.
Cách đếm Token chính xác bằng các công cụ phổ biến
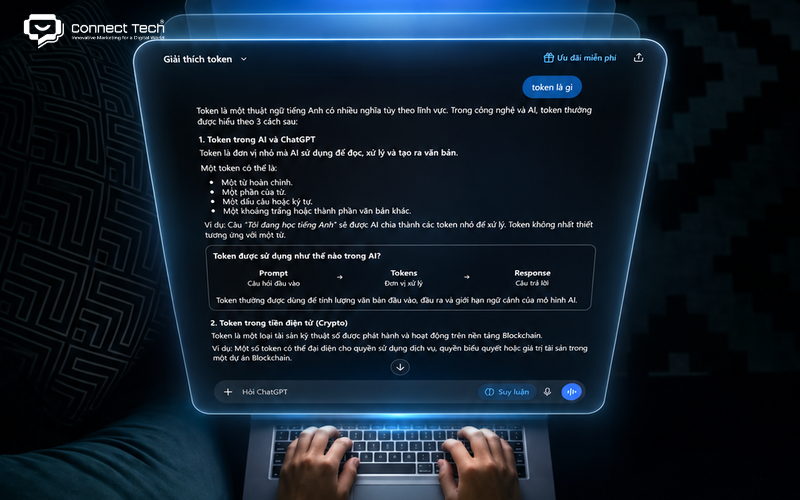
Cách kiểm tra số lượng chính xác hơn việc quy đổi theo số từ là sử dụng tokenizer phù hợp với mô hình AI. Những công cụ này giúp bạn quan sát cách văn bản được chia nhỏ và ước tính lượng dữ liệu cần xử lý.
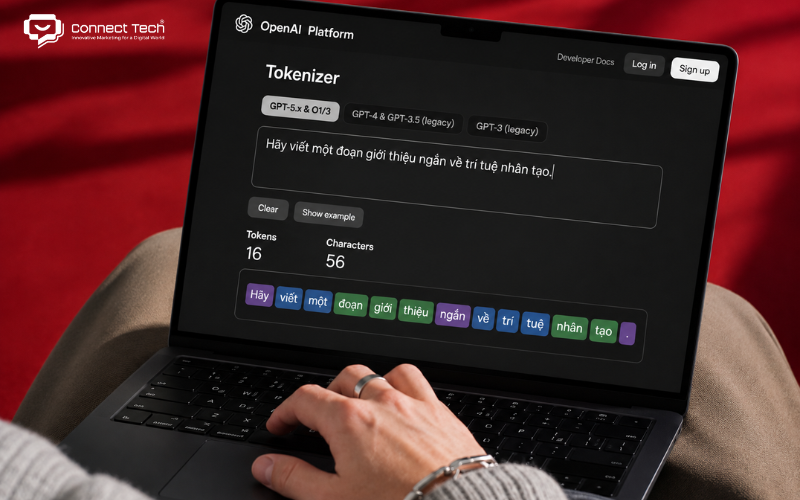
OpenAI Tokenizer là công cụ trực quan giúp người dùng kiểm tra cách văn bản được chia thành các đơn vị nhỏ. Bạn không cần tự viết chương trình để thử nghiệm với một đoạn nội dung thông thường.
Bạn có thể thực hiện theo các bước sau:
- Truy cập công cụ: Mở OpenAI Tokenizer.
- Nhập nội dung: Dán câu hỏi, đoạn văn bản hoặc prompt cần kiểm tra.
- Chọn bộ mã hóa: Nếu giao diện hỗ trợ lựa chọn, hãy sử dụng bộ mã hóa phù hợp với mô hình bạn muốn tìm hiểu.
- Xem kết quả: Quan sát tổng số lượng và cách công cụ phân chia nội dung.
Ví dụ, hãy dán câu "Hãy viết một đoạn giới thiệu ngắn về trí tuệ nhân tạo." vào công cụ. Bạn có thể thấy các phần của câu được phân chia theo quy tắc của bộ mã hóa đã chọn.
Cách tối ưu Token khi sử dụng ChatGPT và AI
Tối ưu token là cách giảm những dữ liệu không cần thiết mà vẫn cung cấp đủ ngữ cảnh để AI hoàn thành yêu cầu. Mục tiêu không phải viết prompt ngắn nhất có thể, mà là giúp mô hình hiểu đúng công việc và tránh phải xử lý thông tin dư thừa.
Bạn có thể áp dụng những phương pháp sau:
- Viết yêu cầu rõ ràng: Nêu trực tiếp công việc, đối tượng và kết quả mong muốn thay vì diễn đạt vòng vo.
- Loại bỏ nội dung lặp: Không nhắc đi nhắc lại cùng một thông tin nếu điều đó không giúp AI hiểu yêu cầu tốt hơn.
- Chỉ cung cấp dữ liệu liên quan: Khi cần phân tích một phần tài liệu, hãy ưu tiên gửi phần nội dung phù hợp với câu hỏi.
- Kiểm soát độ dài đầu ra: Nêu rõ số từ, số ý hoặc định dạng cần nhận để tránh tạo nội dung quá dài.
- Chia nhỏ nhiệm vụ khi cần: Với tài liệu lớn hoặc nhiều yêu cầu phức tạp, hãy tổ chức công việc thành từng phần có mục tiêu rõ ràng.
- Lựa chọn mô hình phù hợp: Không phải công việc đơn giản nào cũng cần sử dụng mô hình có năng lực suy luận cao nhất.
Đối với các ứng dụng sử dụng API thường xuyên, Prompt Caching cũng là một phương pháp đáng quan tâm. Cơ chế này cho phép hệ thống tái sử dụng những phần ngữ cảnh giống nhau ở các yêu cầu khác nhau, từ đó có thể giảm thời gian xử lý và chi phí.
Tuy nhiên, hiệu quả của caching phụ thuộc vào mô hình, tỷ lệ tái sử dụng và cơ chế tính giá. Bạn nên kiểm tra thông tin của nhà cung cấp trước khi áp dụng.
Một prompt hiệu quả cần giữ đủ thông tin quan trọng nhưng loại bỏ những câu lặp hoặc không phục vụ mục tiêu. Hãy xem tình huống một nhân viên Marketing muốn sử dụng ChatGPT để viết mô tả sản phẩm.
Prompt chưa tối ưu:
Tôi đang bán một sản phẩm bình giữ nhiệt. Sản phẩm của tôi là bình giữ nhiệt bằng inox có dung tích 500 ml. Tôi muốn bạn viết một đoạn mô tả sản phẩm này cho khách hàng. Khách hàng mà tôi muốn hướng đến là những nhân viên văn phòng. Bình có dung tích 500 ml và khả năng giữ nóng trong 6 giờ. Tôi muốn đoạn mô tả có độ dài từ 80 đến 100 từ. Bạn hãy viết với giọng văn gần gũi, dễ hiểu và không phóng đại công dụng.
Prompt đã tối ưu:
Viết mô tả 80–100 từ cho bình giữ nhiệt inox 500 ml, giữ nóng 6 giờ. Đối tượng là nhân viên văn phòng. Giọng văn gần gũi, dễ hiểu, không phóng đại công dụng.
Phiên bản thứ hai loại bỏ nhiều câu diễn đạt lặp nhưng vẫn giữ các thông tin quan trọng: sản phẩm, dung tích, công dụng, khách hàng mục tiêu, độ dài và giọng văn. Nhờ đó, AI vẫn có đủ dữ liệu để hoàn thành yêu cầu mà không phải tiếp nhận những phần mô tả dư thừa.
Nếu đưa cả hai đoạn vào cùng một tokenizer, bạn có thể kiểm tra chính xác phần chênh lệch. Tuy nhiên, việc giảm số lượng đầu vào không tự bảo đảm chất lượng phản hồi tốt hơn. Trong những tác vụ như phân tích hợp đồng, nghiên cứu dữ liệu hoặc viết bài SEO chuyên sâu, ngữ cảnh đầy đủ và chính xác thường quan trọng hơn việc tiết kiệm vài dòng văn bản.
Token là một khái niệm quan trọng giúp bạn hiểu cách ChatGPT, Gemini, Claude và những mô hình ngôn ngữ lớn xử lý thông tin. Khi nắm được cách văn bản được chia nhỏ, bạn sẽ dễ hình dung giới hạn ngữ cảnh, kiểm tra độ dài nội dung và quản lý mức sử dụng API.
Hiểu cách xử lý và kiểm soát dữ liệu đầu vào cũng giúp bạn xây dựng prompt rõ ràng hơn, hạn chế thông tin dư thừa và khai thác các công cụ AI hiệu quả trong học tập, công việc và sáng tạo nội dung. Bạn cũng có thể khám phá thêm những công cụ AI tốt nhất cho học tập và công việc được Connect Tech tổng hợp để lựa chọn nền tảng phù hợp với nhu cầu của mình
Mục lục bài viết